신경망인데, 가운데있는 층이많은 것을 DNN(Deep NN)라고 합
니다.
그리고 DNN이 학습하는 것을 Deep Learning이라고 합니다.
딥러닝
https://www.slideshare.net/papisdotio/introduction-to-multi-gpu-deep-learning-with-digits-2-mike-wang
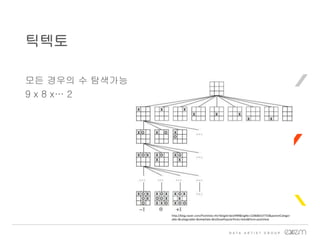
모든 경우의 수탐색가능
9 x 8 x… 2
틱텍토
http://blog.naver.com/PostView.nhn?blogId=best999&logNo=220680107733&parentCategor
yNo=&categoryNo=&viewDate=&isShowPopularPosts=false&from=postView
8.
1996년 딥블루
경우의 수는탐색할 만 하다.
체스
https://www.youtube.com/watch?v=SUbqykXVx0A&feature=youtu.be
9.
모든 경우의 수탐색 불가.
361X 360 x … > 우주 원자 수
바둑
https://www.youtube.com/watch?v=SUbqykXVx0A&feature=youtu.be
10.
• 2개의 네트웤+ MCTS
Alphago를 요약하면
Policy Network Value Network
11.
현재의 판에 대한다음 수를 학습
프로기사의 기보를 사용.
Policy Network
https://www.slideshare.net/ckmarkohchang/alphago-in-depth
• 게임의 끝까지가보지 않아도 된다.
Value Network의 역할
https://www.youtube.com/watch?v=8Z2eLTSCuBk&t=0s
24.
• Monte-Carlose TreeSearch
• 트리 검색 방법
• 이전 최강 프로그램 Pachi이 사용
MCTS
https://en.wikipedia.org/wiki/Monte_Carlo_tree_search
25.
• Alphago의 경우끝까지 가지 않고, 특정 깊이에서 Value
Network의 값을 사용.
MCTS
https://en.wikipedia.org/wiki/Monte_Carlo_tree_search
26.
• Policy Network을사용하여 검색 폭을 줄이고
• MCTS를 사용하여 최선의 가지를 찾고
• Value Network을 사용 하여 검색 깊이를 줄이고
정리하면
https://gogameguru.com/i/2016/03/deepmind-mastering-go.pdf
27.
• Mastering theGame of Go with Deep Neural Networks and
Tree
Search https://gogameguru.com/i/2016/03/deepmind-
mastering-go.pdf
• Google DeepMind's AlphaGo: How it
works : https://www.tastehit.com/blog/google-deepmind-
alphago-how-it-works/
• Alphago in
Depth :https://www.slideshare.net/ckmarkohchang/alphago
-in-depth
Reference