Mo’ Data, Mo’Problem – 책임회피
사실 이 문제는
데이터 수집 방식에 원인이 있습니다.
18.
How to collectmy data
누굴 만났는지 데이터는 자동입력이 불가능하기 때문에 제가 직접 입력합니다
제가 알아서 일관적으로 잘 입력하면 좋았겠지만.
이승훈
이벤트 발생시, 직접 입력
(날짜, 분류, 사람들)
19.
How to collectmy data - 다중인격편
작년의 나, 지난 달의 나, 어제의 나는 각자
같은 의미를 가진 것을 다르게 입력합니다
이승훈
(2015-2-14, 술(or 야식), 친구1, 친구2)
이벤트 발생시, 직접 입력
(날짜, 분류, 사람들)
(2015-2-13, 술_보드카, 친구1’, 친구2)
(2015-2-12, 야식, 친구1’, 친구2)
(2015-2-14, 맥주, 친구1’’, 친구2)
20.
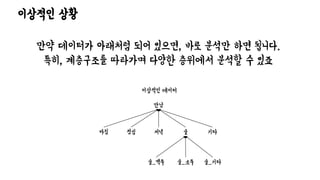
이상적인 상황
만약 데이터가아래처럼 되어 있으면, 바로 분석만 하면 됩니다.
특히, 계층구조를 따라가며 다양한 층위에서 분석할 수 있죠
만남
저녁아침 점심 술 기타
이상적인 데이터
술_맥주 술_소주 술_기타
21.
실제 상황(삐뽀삐뽀)
Level-of-depth 가아주 messy합니다
(종류도 57개)
실제 데이터
만남
저녁아침 점심 야식(or 술)
야식
술_맥주 술_소주
삼겹살 디저트 홍차 커피 아이스크림
간식빵 팥빙수
22.
실제 상황, 응급처치
아주 다행히도, 상위 8개의 카테고리가 전체의 94%를 차지하고 있어
상위 카테고리에 대해서만 전처리를 했습니다.
실제 데이터
만남
저녁아침 점심 야식(or 술)
야식
술_맥주 술_소주
삼겹살 디저트 홍차 커피 아이스크림
간식빵 팥빙수
예를 들어서.
결과: “이승훈이이주석을 제일 많이 만난다”
If you know:
이주석과 이승훈은 같은 연구실이다
Obvious
“대학원생이 연구실 사람 많이
만나는 건 당연한 거 아님?”
27.
예를 들어서.
결과: “이승훈이이주석을 제일 많이 만난다”
If you know:
이주석과 이승훈은 같은 연구실이다
If you don’t know:
이주석과 이승훈은 같은 연구실이다
Obvious
“대학원생이 연구실 사람 많이
만나는 건 당연한 거 아님?”
28.
예를 들어서.
결과: “이승훈이이주석을 제일 많이 만난다”
If you know:
이주석과 이승훈은 같은 연구실이다
If you don’t know:
이주석과 이승훈은 같은 연구실이다
Obvious
“대학원생이 연구실 사람 많이
만나는 건 당연한 거 아님?”
개별 사람에 대한 context modeling이 필요함
29.
Context modelling
그래서 하나하나제가 입력했습니다…
다만, 전체 사람의 수(unique set)의 수는 600명이 넘고,
상위 159명이 전체의 88%를 차지하기 때문에,
상위 159명에 대해서만 컨텍스트를 작성했습니다.
아마도, 이미 예측하셨겠지만.
앞부분이 이렇게 긴 것은
이 발표가 사두지미(뱀머리지렁이꼬리) 형식이기 때문이죠
이제 분석결과를 보여드리겠습니다.
32.
질문1: 케빈 베이컨문제.
“지구에 있는 모든 사람들은
최대 6단계 이내에서 서로 아는 사람으로 연결된다”
정말 그럴까요?
해봅시다.
33.
질문1: 케빈 베이컨문제.
가정:
- 같은 만남을 가진 집단 (a, b, c)에는 (a, b), (b, c), (c, a)라는 관계가 성립
- weight, directionality를 무시
- 또한 ‘이승훈’이 없는 세상이라고 가정(무섭..ㅠㅠ)
- 당연하지만, 이승훈이 있을 경우, 최대 2 단계면 모두 연결됨
Anyone Anyone
me
34.
질문1: 케빈 베이컨문제.
여러분이 보기 편하시도록 그림을 그렸습니다.
>>> import networkx as nx
>>> G = nx.Graph(list(set([edge for edge in edge_lst])))
>>> plt.figure()
>>> nx.draw_shell(G)
>>> plt.show()
이를 통해 우리는 모든 사람이 6단계로 연결된다는 것을 알 수 있습니다.
35.
질문1: 케빈 베이컨문제.
여러분이 보기 편하시도록 그림을 그렸습니다.
>>> import networkx as nx
>>> G = nx.Graph(list(set([edge for edge in edge_lst])))
>>> plt.figure()
>>> nx.draw_shell(G)
>>> plt.show()
이를 통해 우리는 모든 사람이 6단계로 연결된다는 것을 알 수 있습니다.
(잘보면 보여요)
36.
질문1: 케빈 베이컨문제.
3 가지의 connected component가 나오는 것을 알 수 있습니다.
꼼꼼히 보면, 집단1: 학교 사람(친구 등), 집단2: 훈련소, 집단3: 가족
>>> subG_lst = [subG for subG in nx.connected_component_subgraphs(G)]
>>> print()
>>> for subG in subG_lst:
print('graph size:', len(subG.nodes()), ', path:', max_shortest_path_and_its_length( subG ) )
>>>
graph size: 146 , path: (['p119', 'p39', 'p106', 'p96', 'p63', 'p32', 'p81'], 6)
graph size: 9 , path: (['p25', 'p20'], 1)
graph size: 2 , path: (['p29', 'p14'], 1)
37.
질문1: 케빈 베이컨문제.
‘친구’집단의 longest shortest path
p119 p39 p106 p96 p63 p32 p81
친형의 친구 같은 동아리 같은 학과 같은 동아리 독서모임 독서모임
방글라데시에서
일하는 영업사원
포항공대 교직원
되…되잖아…
38.
질문1: 케빈 베이컨문제.
또한, 실제로 존재하는 관계가 있습니다, 이를 고려하면, 더 가까워지겠죠.
친구
가족 훈련소
me
p7
p14
p24
p13
39.
질문1: 케빈 베이컨문제.
다만, 지금까지 분석한 것은 이미 필터링된 사람들을 대상으로 합니다.
그렇다면,
전체 데이터를 대상으로 해보면 어떤 결과가 나올까요?
그래도 케빈베이컨 수가 유지될까요?
40.
질문1: 케빈 베이컨문제.
총 8개의 component로 구분되긴 하지만,
가장 큰 graph의 경우 544개의 사이즈, 7단계를 거치면, 다 만난다는 것을 알 수 있네요
그럼 여기에, 제가 아는 edge들 새로 7개를 추가해서 돌려보겠습니다.
>>> for i, sub_G in enumerate(nx.connected_component_subgraphs(total_G)):
temp = max_shortest_path_and_its_length(sub_G)
print("subGraph "+str(i)+" size:", len(sub_G), "max shortest path:", temp[1])
>>>
subGraph 0 size: 544 max shortest path: 7
subGraph 1 size: 9 max shortest path: 1
subGraph 2 size: 10 max shortest path: 3
subGraph 3 size: 9 max shortest path: 3
subGraph 4 size: 14 max shortest path: 3
subGraph 5 size: 3 max shortest path: 1
subGraph 6 size: 4 max shortest path: 2
subGraph 7 size: 2 max shortest path: 1
41.
질문1: 케빈 베이컨문제.
component를 많이 줄이긴 했지만, 그래도 닿지 못하는 사람들이 있습니다.
나머지 component는
<여행에서 만난 사람들1>, <여행에서 만난 사람들2>, <업무 회의로 만난 사람>으로 정리됩니다.
>>> total_G.add_edges_from(new_edges)
>>> for i, sub_G in enumerate(nx.connected_component_subgraphs(total_G)):
temp = max_shortest_path_and_its_length(sub_G)
print("subGraph "+str(i)+" size:", len(sub_G), "max shortest path:", temp[1])
>>>
subGraph 0 size: 567 max shortest path: 7
subGraph 1 size: 9 max shortest path: 3
subGraph 2 size: 16 max shortest path: 3
subGraph 3 size: 3 max shortest path: 1
42.
질문1: 케빈 베이컨문제.
전체를 묶지 못했고, 또 거리가 커지기는 했지만
그래도, 가장 큰 컴퍼넌트에서 보면, 꽤 먼 사람이 이어지기는 합니다
p410 p13 p67 p85 p8 p15 p30 p321
포항 단편
영화 감독
천안 사는
공무원 준비생
그래도, 이정도면 좀 유의미하지 않나? 싶어요
케빈베이컨 짝짝짝
아침/점심/저녁/야식+술 로 구분해서차이를 확인하겠습니다.
우선, 전체를 대상으로 한 순위부터 보시죠
우선 전체를 대상으로 한 순위부터 보시죠
질문3: 카테고리별로 만나는 사람이 다른가?
52.
전체 빈도 순위
gc1 dept CCs
p0 남성 포스텍 산업경영공학과 [연구실사람]
p1 남성 포스텍 산업경영공학과 [연구실사람]
p2 남성 포스텍 산업경영공학과 [연구실사람]
p3 남성 포스텍 산업경영공학과 [연구실사람]
p4 남성 포스텍 산업경영공학과 [연구실사람, 5분반]
p5 남성 포스텍 산업경영공학과 [연구실사람]
p6 남성 포스텍 산업경영공학과 [연구실사람]
p7 남성 포스텍 화학공학과 [준비위원회]
P8 남성 포스텍 신소재공학과 [피펑크, 준비위원회]
P9 남성 포스텍 산업경영공학과 [연구실사람]
- 상위 10명이 전체 만남의 58.4%를 차지함
- 상위 10명이 모두 같은 학교
- 8명은 같은 학과, 연구실
- 2명은 학부 친구
‘연구실 사람을 제일 많이 만난다’
라는 너무도 당연한 결론
Meta-data Management
데이터가 많을수록,데이터 간의 관계와 특성을 고려하는 것이 중요.
그렇지 않을 경우, 기대 만큼의 성과를 얻기 어려울 수 있음.
(특히, 오랫동안 쌓인 데이터에서는 concept-drift가 발생하기 쉬움)
또한, 카테고리 데이터의 경우는 level-of-depth,
층위 별 span-of-control을 꾸준하게 관리해주는 것이 중요함
(Data consistency or constraint management)
66.
Analytic-orientation
데이터를 모으는 것도물론 중요하지만,
향후 해당 데이터를 어떻게 분석할 지에 대해 충분히 고려한 다음
(analytic-oriented) Data schema를 설계하는 것이 좋다.
그래야 향후 발생할 수 있는 문제점 및 데이터 전처리 비용이 감소함
다시 말하지만, (나처럼) 그냥 모으면 답이 없다