NoSQL 이해 및 활용
전영규
HISTORY
1980
1990
2000
2010
Relational Database
1980
1990
2000
2010
Relational Database
Object Database
20년 동안
Relational Database 지배
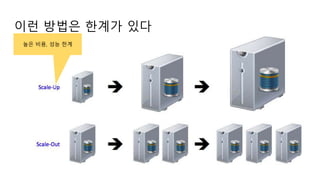
많은 트래픽
높은 비용, 성능 한계
이런 방법은 한계가 있다
Sharding
id 1-2 id 3-4 id 5-6
APPLICATION
id 7-8 id 9-0
slave Slave slave Slave. . .
Master Master
BigTable, DynamoDB
NoSQL
RDBMS VS NoSQL
RDBMS
relational
table
row
column
schema
join
transaction
stored Procedure
trigger
index
focus on consistency
centralized
NoSQL
non-relational
open-source
cluster
schema less
decentralized
distributed systems
no transaction
no join
focus on availability
simpler and faster
VERSUS
Relational DBMS ACID
Atomicity
부분적으로 실행되다가 중단되지 않음
예) 은행 계좌 예제 에서 송금시 금액 감소, 금액 증가 동시에 성공 해야
Consistency
트랜잭션이 성공적으로 완료 하면 언제나 일관성 있는 데이터 유지
Isolation
특정 트랜잭션 수행 시 다른 트랜잭션의 연산 작업을 볼 수도 끼어 들수도 없음
Durability
성공적으로 수행된 트랜잭션은 영원히 반영 되어야 함.
NoSQL BASE
Basic availability
클러스터 덕분에 기본적으로 Available
Soft-state
입력 데이터가 없는 상황 에서도 시스템의 상태는 항상 변경 될 수 있음
Eventual consistency
잠시동안 데이터가 inconsistency 할 수 있으나 결국에는 consistency 상태
ACID versus BASE
Consistency VS Availability
Consistency
- 항상 같은 데이터가 응답 되어야 한다.
- 예) 하나 주문만 되어야 한다. 중복 예약은 발생 할 수 없음
- RDBMS 에서는 transaction 하여 데이터 consistency 보장
Availability
- 언제나 응답할 수 있음
- 예) 서버중에 장애가 발생해도 서비스 할 수 있음. 그렇지 않은 경우는 장애 페이
지
CAP VS PACELC theorem
- CAP대한 논란이 많음.
- Partition Tolerance 정의가 일관성이 없다는 의견
- CAP 장애 상황 일 경우는 성립이 됨
- CAP 보다 명확함
- 정상 상황 일때 와 장애 상황 일때 의 특성을 파악
- 네트워크 장애 상황 일 때는 A/C 둘 중 선택
장애 상황일 아닐때는 L(Latency)/C 중 선택
if there is a partition (P) how does the system tradeoff
between availability and consistency (A and C); else (E)
when the system is running as normal in the absence of
partitions, how does the system tradeoff between latency
(L) and consistency (C)?
NoSQL 종류
Key-value store
- Memcached, Redis, Riak, DynamoDB, Berkeley DB
Graph store
- Neo4j, InfiniteGraph, AllegroGraph, S2Graph(카카오)
Column family store
- Apache Cassandra, HBase, Accumulo
Document store
- MongoDB, CouchDB, CouchBase, RavenDB, MarkLogic
Key-value store
HashMap
Key-value store 활용
- 대표적인 key-value store memcached/Redis
- Memcached는 논리적으로 메모리를 combine 함으로써
낭비되는 메모리가 적음
- memcached web cache로 사용
Document Store
No Schema
Document Store 활용
뉴스 사이트
Blog
회원 가입
복잡한 상품 정보 JSON 포맷 으로 저장
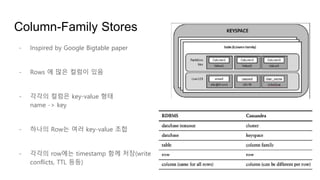
Column-Family Stores
- Inspired by Google Bigtable paper
- Rows 에 많은 컬럼이 있음
- 각각의 컬럼은 key-value 형태
name -> key
- 하나의 Row는 여러 key-value 조합
- 각각의 row에는 timestamp 함께 저장(write
conflicts, TTL 등등)
Column-Family Stores 활용
- Event Logging(application 마다 고유의 컬럼을 가짐)
application state, error log
- E-Commerce
상품 추천, 장바구니 등등
Graph Databases
- entities와 entities 사이의 relationship
을 저장
- entities -> “Node”
속성(박지성, 기성용)을 가짐
- relation -> “edge”
방향과, 속성(like, friend)을 가짐
- relationship 데이터에 특화 되어 있음
Graph Databases 활용
- relationship 을 분석 하는데 최적화
social networking
recommend
가족 관계
shortest-path
왜 NoSQL을 쓰는가?
개발하기 쉽다
big data 처리 가능
Cassandra 파헤치기
- Big Table & Dynamo 장점만
- PA/EL
Cassandra Data Structure
Cassandra Ring
- Cassandra cluster is called a ring.
- cassandra 1.1 이전 버전에서는
각각의 노드는 token range를 가지고
있었음.
- 노드를 추가 하거나 제거할 때
token range를 수동으로 계산.
- 또한 특정 노드를 새로운 노드로
Cassandra 1.1 이후 Virtual nodes
- 기존의 cassandra ring 문제점을 해결하기 위해 고안
- 각각의 노드는 small range 를 가짐
range 는 자동으로 계산된다.
- 빠른 복구 가능
1.1 version 이하 -> 큰 범위를 가진 노드에서 복구
1.1 이상 -> small range를 가진 여러 노드로 부터
받기 때문에 복구 속도 빠름
Cassandra Write
- client cassandra 어느 노드들 중에 하나에 write 요청을
함. 이 노드를 coordinator 라고 함
- coordinator는 해당 데이터의 Row key를 hashing 하여
어느 노드에 저장할지 결정
- Consistency Level에 따라 몇 개의 노드에 write 할지 참
고 함.
- 특정 노드 상태가 정상이 아니라면 hint hand off 라는 공
간에 write 데이터 저장
노드가 정상으로 돌아올 때 데이터를 write 하기 위함
Cassandra write
- 데이터 write 요청이 들어 오면 MemTable 메모리에 저장
장애에 대비 하기 위해 Commit log 로컬 디스크에 저장
- MemTable에 데이터가 쌓이면 SSTable 에 데이터를 flush
- SSTable은 immutable 하고 sequential 특징이 있어 다수의 SSTable을 관리
Cassandra Read
- client 가 read시 cassandra 노드들중 하나만
coordinator로 지정. 해당 요청의 row key를 hashing 하
여 접근해야할 노드위 위치 파악
- Consistency Level을 체크하여 몇 개의 Replication 을
확인 할지 결정 후 가장 가까운 노드에 read 요청을 함.
- 다른 가까운 노드들에는 Data Digest Request 를 함.
- Data와 Data Digest Request를 비교하여 일치 하지 않
으면 모든 노드들로부터 full date를 가지고 와 그중 가
장 최신 데이터 리턴
- 이후에 conflicting 노드 들은 최신 데이터로 업데이트.
1) 데이터 read 요청이 들어오면 먼저 MemTable을 확인함.
2) 데이터가 없다면 Multiple SSTable에 바로 접근 하는게 아니라 Bloom Filter, Index를 먼저 확인
3) 각각의 SSTable은 메모리에 저장되는 bloom filter를 확인하여 해당 데이터가 있는지 빠르게 확인
4) 데이터가 없으면 여러 다른 bloom filter 확인 하면서 데이터를 확인
5) 데이터가 확인되면 index를 뒤져 해당 데이터의 offset 정보 취득 후 빠르게 SSTable 에서 해당 데이터 retrieve
Cassandra Read within a node
Delete Data
- 데이터 삭제 요청이 있을 때 데이터를 바로 삭제 하는 것이 아님
- 해당 데이터에 tombstone marker를 표시하고 SSTables compaction시 데이터 삭제함
- 데이터가 삭제 되더라도 Tombstone이 marked 되어 있는 것일 뿐 여전히 Disk에 존재 함.
- 따라서 SSTable 의 데이터를 Sequential 하게 읽어야 하는 Cassandra 특징 때문에 Tombstone 데이터는 무조건 읽
힘.
- 이러한 이유 때문에 Queue 방식으로 Cassandra를 사용하면 안된다.
Cassandra Query Language (CQL)
KEYSPACE
CREATE KEYSPACE RECOMMEND WITH REPLICATION = {‘CLASS’ : ‘NetworkTopologyStrategy’, ‘DC1’ : 3}
TABLE
CREATE TABLE RECOMMEND.ITEMBASE(
ITEM_ID TEXT,
RECOMMEND_ID TEXT,
PRIMARY KEY(ITEM_ID)
);
SELECT
SELECT ITEM_ID FROM RECOMMEND.ITEMBASE;
DELETE
DELETE FROM RECOMMEND.ITEMBASE WHERE ITEM_ID = ‘1’;
UPDATE
UPDATE RECOMMEND.ITEMBASE SET RECOMMEND_ID = ‘2’ WHERE ITEM_ID = ‘1’;
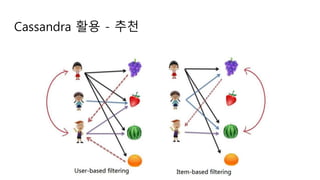
Cassandra 활용 - 추천
1980
1990
2000
2010
Relational Database
Object Database
20년 동안
Relational Database 지배
Polyglot persistence
Microservice
NEO4j cassandra
Riak
SUMMARY
- NoSQL는 항상 좋은 툴이 될 수 없다.
Domain, Business rule에 따라 신중한 결정이 필요하다
- 잘만 사용하면 이보다 좋을 수 없다
- NoSQL은 계속 진화 하고 있다.
ACID 지원 하는 NoSQL 있음(예 : RAVEN DB)
참고 서적
참고 사이트
https://www.youtube.com/watch?v=qI_g07C_Q5I&t=142s (강추 Martin Fowler NoSQL)
http://eincs.com/2013/07/misleading-and-truth-of-cap-theorem/ (CAP Theorem, 오해와 진실)
http://meetup.toast.com/posts/58 Apache Cassandra 톺아보기 - 1편
http://meetup.toast.com/posts/60 Apache Cassandra 톺아보기 - 2편
http://meetup.toast.com/posts/65 Apache Cassandra 톺아보기 - 3편