Hadoopのシステム構築・運用のポ
    イント	
  
    Cloudera	
  カスタマーオペレーションズエンジニア	
  
    嶋内 翔	
  
    2012年11月7日	


1
アジェンダ	
  

    •    構築と運用のポイント	
  
         •    ハードウェア編	
  
         •    コンポーネント共通	
  
         •    HDFS	
  
         •    MapReduce	
  
    •    トラブルシューティング	
  
         •    HDFS	
  
         •    MapReduce	
  
    •    CDHのアップグレード	


2
自己紹介	
  

•    嶋内 翔(しまうち しょう)	
  
•    2011年4月にClouderaの最初の日本人社員として入
     社	
  
•    カスタマーオペレーションズエンジニアとしてテクニ
     カルサポート業務を担当	
  
•    email:	
  sho@cloudera.com	
  
•    twiBer:	
  @shiumachi	
  
構築と運用のポイント	
  
ハードウェア編	
  
ハードウェア選定の基本的な考え	
  

•    スレーブノード	
  
     •    コモディティサーバを使う	
  
     •    コモディティ=コストパフォーマンスが高い	
  
          •    ローエンドサーバではない!	
  
•    マスタノード	
  
     •    従来の高信頼性サーバを使う	
  
•    ネットワーク	
  
     •    ラック内ネットワークは1GbitLANで十分	
  
     •    ラック間ネットワークは10GbitLANが必要	
  
     •    これも構築時に一番コストパフォーマンスが高いものを選
          択する	
  
ハードウェア選択:スレーブノード	
  
•    スレーブノードでは以下のサービスが稼働する	
  
     •    データノード(HDFS)	
  
     •    タスクトラッカー(MapReduce)	
  
     •    リージョンサーバ(HBase)	
  
•    ディスクを大量にRAIDなしで積む	
  
     •    エントリーモデル:	
  1TB	
  *	
  8	
  
     •    標準:	
  2TB	
  *	
  8	
  
     •    高集約型:	
  3TB	
  *	
  12	
  
     •    SSD	
  も	
  15000rpm	
  も不要。3.5inch	
  7200rpm	
  SATAで十分	
  
•    CPU	
  もコストパフォーマンスを重視しつつ可能な限り多めに積む	
  
     •    エントリーモデル:	
  4core	
  *	
  2	
  
     •    標準:	
  6core	
  *	
  2	
  
•    メモリも	
  CPU	
  と同様、コストを見つつなるべく多めに	
  
     •    エントリーモデル:	
  32GB	
  (HBase	
  を使う場合:	
  48GB)	
  
     •    標準:	
  48GB	
  (HBase	
  を使う場合:	
  64GB)	
  
     •    ECC	
  必須!	
  
ハードウェア選定:	
  マスタノード	
  
•    マスタノードでは以下のサービスが稼働する	
  
      •    NN,	
  SNN(HDFS)	
  HA構成の場合はSNN	
  ではなくスタンバイネームノード	
  
      •    ジョブトラッカー(MapReduce)	
  
      •    HMaster(HBase)	
  
      •    Zookeeper(HBase,	
  HA)	
  
      •    JournalNode(HA)	
  
•    ディスクは必ずRAIDを組むこと	
  
      •    1TB	
  *	
  4,	
  RAID1+0	
  
      •    SSD	
  も	
  15000rpm	
  も不要。3.5inch	
  7200rpm	
  SATAで十分	
  
•    CPUは、1サービス1コアを確保すれば、後はそれほど必要ない	
  
      •    4core	
  *	
  2	
  
•    メモリ	
  
      •    データ量が多くなるとネームノードの使用量は増えるのでそれを考慮しておく	
  
      •    最低24GB。数百ノードクラスタの場合は48GBは必要	
  
      •    ECC	
  必須!	
  
クラスタ構成	
  

•    スレーブ:	
  最低4ノード	
  
     •    デフォルトのファイルレプリケーション数(3)	
  +	
  1	
  
     •    性能を発揮するための最低値ではない。あくまで評価用	
  
•    マスター:	
  2台	
  
     •    1台にNN、HMaster、ZK、JournalNode	
  
     •    もう1台にSNN,	
  JT,	
  HMaster、ZK、JournalNode	
  
•    Zookeeper、JournalNodeマシン:1台	
  
     •    Zookeeper	
  は必ず奇数台(3台or5台)配置する	
  
     •    マシンスペックはそれほど必要ない(必要メモリ1GB程度)	
  
     •    マスターと同居してもいいので最小構成の場合は専用
          サーバは実質1台のみ必要	
  
ハードウェア選定のアンチパターン	
  
•    RAIDを組んでしまう	
  
      •    Hadoop	
  は複数のタスクが異なるディスクに読み書きすることで性能を確保している	
  
      •    RAIDを組むとこのメリットが失われる	
  
      •    RAID0	
  は絶対禁止! 特定ベンダのファームウェアバグによりデータロストが発生した事例あ
           り	
  
•    マスタのディスクを非常に少ない容量にする	
  
      •    ネームノードは名前空間のイメージファイルや編集ログを保存するため、ある程度の容量は
           必要(最低1TB)	
  
      •    128GBディスクを使っていてディスクあふれを起こした事例あり	
  
•    CPU	
  数を減らす	
  
      •    1ノードでMapReduceのタスクを多く動かすにはCPUが必要	
  
      •    各デーモンは CPU	
  を1コア使うものとして計算する	
  
•    ECCメモリを使わない	
  
      •    障害発生の事例あり	
  
•    構築時にHBaseを想定せずにハードウェア選定し、その後HBaseを追加する	
  
      •    HBase	
  を追加すると、スレーブは	
  +1コア、+16GBメモリ余計に必要になる	
  
      •    特にメモリ不足が非常に問題	
  
運用のポイント	
  

•    スレーブノードは簡単に壊れる	
  
     •    数百ノードクラスタ:	
  1日1スレーブノードに障害発生、ディスクは
          もっと高頻度	
  
•    スレーブノードが壊れてもあわてない	
  
     •    Hadoopはデータを冗長化しているので1台壊れても問題ない	
  
•    Yahoo.com	
  は3ヶ月に1回の割合で壊れたサーバを一斉
     に補修・入れ替え	
  
•    緩い運用をすることで運用コストの削減が可能	
  
     •    ただしハードウェアの調達については十分な量を確保できるよ
          うにしておく	
  
•    逆に構築時にはサーバ台数や容量に余裕を持たせて
     おく	
  
構築と運用のポイント	
  
         コンポーネント共通	


11	
  
CDH3からCDH4の変更点	
  

     •    パラメータ名が大きく変更	
  
          •  例:	
  fs.default.name	
  は fs.defaultFS	
  に変更	
  
          •  古いパラメータ名を使っていても	
  deprecated	
  という	
  WARN	
  ログが出る
             だけで実害なし	
  
          •  Cloudera	
  Manager	
  でアップグレードした場合は自動的に変更される	
  
          •  変更パラメータ一覧
             hBp://archive.cloudera.com/cdh4/cdh/4/hadoop/hadoop-­‐project-­‐
             dist/hadoop-­‐common/DeprecatedProperbes.html	
  
     •    コマンド名が大きく変更	
  
          •  hadoop	
  コマンドだけだったものが hdfs/mapred	
  コマンドに分割	
  
          •  hadoop	
  コマンドを継続利用しても	
  deprecated	
  の	
  WARN	
  ログが出るだ
             けで実害なし	
  
     •    MapReduce1	
  
          •    中身はCDH3のJT/TTとほぼ同じ(hadoop-­‐0.20ベース)	
  

12
OS・コンポーネント共通チェックポイント	
  

     •    Oracle	
  Java	
  6	
  を使うこと	
  
           •    Oracle	
  Java	
  7	
  は未対応(来年対応予定)	
  
           •    OpenJDKやその他のJavaは未対応	
  
     •    DNS	
  や	
  /etc/hosts	
  をチェックし名前解決がきちんと
          できているかどうか確認	
  
     •    SELinuxは切ってください	
  
     •    64ビットOSを使ってください	


13
圧縮	
  

     •    圧縮は絶対に使ってください	
  
     •    メリット1:	
  容量を節約できる	
  
          •    Hadoop	
  クラスタの場合サーバ何十台分に相当	
  
     •    メリット2:	
  MapReduceの速度が上がる	
  
          •    MapReduce	
  ジョブはディスクボトルネック、つまりCPUリソース
               は余る傾向にある(圧縮・展開はCPU利用の処理)	
  
          •    圧縮・展開にかかる時間 > 非圧縮時のデータの読み書き時
               間	
  
     •    Snappy	
  圧縮を推奨	
  
          •    LZO	
  と同じ、圧縮・展開速度重視のアルゴリズム	
  
          •    LZO	
  (GPL)と違いApacheライセンスのため、最初からHadoopに
               組み込まれている	
  

14
構築と運用のポイント	
  
         HDFS	


15	
  
HDFSの安定運用のためのガイドライン	
  

     •    DN	
  のブロック数を少なくすること	
  
     •    DN	
  のヒープサイズを十分に確保すること	
  
          •     DN:	
  1GBのヒープで100万ブロック	
  
                •    JVMオプションで-­‐XX:+UseCompressedOops	
  を有効にしていない場合は倍の
                     ヒープが必要	
  
     •    NN	
  のヒープサイズを十分に確保すること	
  
           •    NN:	
  1GBのヒープで100万ファイル	
  
     •    SNN	
  のヒープサイズはNNと同じにすること	
  
     •    CDH3u2	
  以前のクラスタでは2万ブロック/DNが限界	
  
           •    HDFS-­‐2379	
  (非同期ブロックレポート)	
  
     •    ブロックサイズは最低でも128MBに設定すること	
  
           •    データ量があまりに多い(PB以上)場合は256MBも検討	
  

16
HDFSのサイジング	
  

     •    必要なストレージは実データに比べてはるかに多い	
  
          •    レプリケーションファクターが3	
  
          •    MapReduceの中間データなども書き込まれる	
  
          •    実データに対し4-­‐5倍の余裕はほしい	
  
          •    OS等の非HDFS用の容量も必要なことも忘れずに	
  
     •    ストレージ容量が1ノードあたり16TBとすると、実
          データとしては3-­‐4TB相当	
  
     •    例:	
  100ノードクラスタなら実データとしては400TB程
          度(DFS容量としては1.2PB)	


17
NNの最大ヒープサイズ	
  

     •    NNのヒープサイズは大体60GBぐらいが限界	
  
          •    これ以上になるとGCが長くなり、サービスに影響が出る	
  
     •    ブロックサイズ128MBとすると約7.2PBのデータに相
          当	
  
     •    ノードあたり16TBのストレージを持っているとすると、
          458ノードに相当	
  
          •    容量に余裕を持たせなければいけないことを考慮すれば
               500-­‐600ノードに相当	


18
フェデレーション?	
  

     •    実際には十分な空き容量を要すること、この規模な
          らブロックサイズ256MBにすることから、単純計算で
          1800-­‐2000ノード程度は単一のNNで管理可能	
  
     •    よって、1000ノード/10PBクラスより小さければフェデ
          レーションはほとんどのケースにおいて考慮する必
          要はない	


19
NNメタデータ	
  

     •    メタデータディレクトリ	
  
          •    dfs.name.dir	
              CDH3	
  

          •    dfs.namenode.name.dir	
     CDH4	
  

     •    必ずカンマ区切りで3ヶ所のディレクトリを指定するこ
          と(うち1ヶ所はNFS)	
  
          •    QJMを使う場合、コストパフォーマンス的にNFSなしでも問
               題ない(ローカル+リモートという冗長性は確保されている
               ため)	


20
データノードのディレクトリ	
  

     •    dfs.data.dir	
            CDH3	
  

     •    dfs.datanode.data.dir	
   CDH4	
  
     •    ディスクのマウントポイントごとに別々のディレクトリ
          をカンマ区切りで指定すること	
  
          •    でないとJBODで構築した意味がない	


21
構築と運用のポイント	
  
         MapReduce	


22	
  
チューニングの基本的な考え方	
  

     •    一般的なチューニングの鉄則「遅いものはなるべく
          使わない」	
  
          •    ディスク読み書き(特に書き込み)を極力減らす	
  
          •    ネットワーク転送を極力減らす	
  
          •    メモリに極力乗せるようにする	
  
     •    map	
  を最小の「波(wave)」で終わらせる	
  
          •    入力ファイルが100ブロックあるとき、mapタスクのスロット
               が合計50あれば2waveで完了する。このときさらに10ス
               ロット追加しても結局2waveかかるので効果は薄い	


23
タスクスロット	
  

     •    タスクスロットとは、そのTTでmap/reduceタスクを実
          行するための予約枠のこと	
  
     •    スロット数分だけタスクが同時実行される	
  
     •    map	
  と	
  reduce	
  で別々に最大値を割り当てる必要が
          ある	


24
最適なタスクスロット数の計算方法	
  

     •    総スロット数	
  =	
  CPUコア数	
  -­‐	
  稼働しているサービス数
          (DN,TTだけなら2、RSが動いているなら3)	
  
          •    ハイパースレッディング(HT)を使用しているならコア数1.5
               倍で計算	
  
     •    mapタスク数:reduceタスク数	
  =	
  4:3	
  or	
  2:1	
  
          •    最適解でなく、あくまでスタートライン	
  
          •    実際は本番環境で実データを流しながら微調整すること	
  
     •    次ページのメモリ計算式を見ながらリソース枯渇し
          ないように計算すること	
  
     •    タスク数 >	
  ディスク数になるとIO性能が落ちるので、
          ディスク数が非常に少ない場合は注意	
  

25
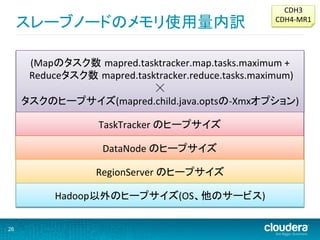
CDH3	
  
     スレーブノードのメモリ使用量内訳	
                                        CDH4-­‐MR1	


          (Mapのタスク数 mapred.tasktracker.map.tasks.maximum	
  +	
  
      	
  Reduceタスク数 mapred.tasktracker.reduce.tasks.maximum)	
  	
  
                                ☓	
  
     タスクのヒープサイズ(mapred.child.java.optsの-­‐Xmxオプション)	
  

                      TaskTracker	
  のヒープサイズ	
  

                       DataNode	
  のヒープサイズ	
  

                      RegionServer	
  のヒープサイズ	
  

            Hadoop以外のヒープサイズ(OS、他のサービス)	
  

26
CDH4-­‐MR2	
  
     スレーブノードのメモリ使用量内訳	
  

            (Mapのタスク数 mapreduce.tasktracker.map.tasks.maximum	
  
                                  	
  +	
  
       	
  Reduceタスク数 mapreduce.tasktracker.reduce.tasks.maximum)	
  	
  
                                  ☓	
  
          タスクのヒープサイズ(mapred.child.java.optsの-­‐Xmxオプション)	
  

                      TaskTracker	
  のヒープサイズ	
  

                       DataNode	
  のヒープサイズ	
  

                     RegionServer	
  のヒープサイズ	
  

          Hadoop以外のヒープサイズ(OS、他のサービス)	
  

27
タスクスロット計算例(1)	
  

     •    4*2コア(HTあり)、メモリ	
  32GB	
  ノード、HBase	
  あり	
  
     •    総スロット数	
  =	
  8*1.5	
  -­‐	
  3	
  =	
  9	
  
          •    mapタスクスロット	
  6	
  
          •    reduceタスクスロット	
  3	
  
     •    mapred.child.java.opts	
  -­‐Xmx1g	
  とすると、タスク用の
          ヒープは9GB必要	
  
     •    TT/DNが1GBづつ、RSが16GB使うと考えるとスレーブ
          ノードに必要なメモリ領域は最低27GBとなる	
  
          •    よってメモリ32GBでとりあえず足りると言える	
  
          •    CPUの利用傾向を見てもっとスロット数が確保できそうな
               らメモリも48GBぐらいあると安心	
  

28
タスクスロット計算例(2)	
  

     •    6*2コア(HTあり)、メモリ48GB	
  ノード、HBase	
  あり	
  
     •    総スロット数	
  =	
  12*1.5	
  -­‐	
  3	
  =	
  15	
  
          •    mapタスクスロット	
  10	
  
          •    reduceタスクスロット	
  5	
  
     •    mapred.child.java.opts	
  -­‐Xmx1g	
  とすると、タスク用の
          ヒープは15GB必要	
  
     •    TT/DNが1GBづつ、RSが16GB使うと考えるとスレーブ
          ノードに必要なメモリ領域は最低33GBとなる	
  
          •    メモリ32GBだと足りないので48GBは必要	


29
トラブルシューティング	
  
HDFS	
  
CDH3	
  
     HDFS	
  障害時	
  
     •    とりあえずこのコマンドを実行	
  
           •    hadoop	
  fsck	
  /	
  
           •    hadoop	
  dfsadmin	
  -­‐report	
  
           •    hadoop	
  fs	
  -­‐lsr	
  /	
  (必要に応じて)	
  
     •    動作確認	
  
           •    hadoop	
  fs	
  -­‐put	
  <ファイル>[スペース]/tmp	
  	
  
           •    hadoop	
  fs	
  -­‐get	
  /tmp/<ファイル>	
  
     •    セーフモード	
  
           •    セーフモードに入っていないかどうかチェック	
  
                  •    hadoop	
  dfsadmin	
  -­‐safemode	
  get	
  
     •    ブロックスキャナレポート	
  
           •    落ちてないけど遅い場合はこれを調べる	
  
           •    hBp://dn:50075/blockScannerReport	
  
           •    個々のブロックの詳細情報が欲しい場合 hBp://dn:50075/blockScannerReport?
                listblocks	
  
     •    JMX	
  メトリクス	
  
           •    hBp://dn:50075/jmx	


31
CDH4	
  
     HDFS	
  障害時	
  
     •    とりあえずこのコマンドを実行	
  
           •    hdfs	
  fsck	
  /	
  
           •    hdfs	
  dfsadmin	
  -­‐report	
  
           •    hdfs	
  dfs	
  -­‐ls	
  -­‐R	
  /	
  (必要に応じて)	
  
     •    動作確認	
  
           •    hdfs	
  dfs	
  -­‐put	
  <ファイル>[スペース]/tmp	
  	
  
           •    hdfs	
  dfs	
  -­‐get	
  /tmp/<ファイル>	
  
     •    セーフモード	
  
           •    セーフモードに入っていないかどうかチェック	
  
                   •    hdfs	
  dfsadmin	
  -­‐safemode	
  get	
  
     •    ブロックスキャナレポート	
  
           •    ブロックのチェックサムの検証結果を表示できる	
  
           •    hBp://dn:50075/blockScannerReport	
  
           •    個々のブロックの詳細情報が欲しい場合 hBp://dn:50075/blockScannerReport?
                listblocks	
  
     •    JMX	
  メトリクス	
  
           •    hBp://dn:50075/jmx	


32
メタデータ破損の疑いがある場合	
  

     •    分かる人が来るまで絶対にシャットダウンしない	
  
     •    NN	
  は fsimage	
  をメモリ上に保持していて、起動時以
          外読み込まない	
  
          •    シャットダウンすると、メモリ上の正常なメタデータが失わ
               れる	
  
          •    hdfs	
  dfsadmin	
  -­‐fetchImage	
  <保存先ディレクトリ>	
  でNNのメ
               モリ上のfsimageを保存可能	
  
          •    ローカルのfsimage/editsが壊れていると判断した場合の
               最後の手段の一つ(もう一つは後述)	


33
HDFSリカバリーモード	
  
     •    HDFS障害復旧における最後の手段	
  
     •    Linuxのfsckコマンドのように、editsが壊れていても部分
          的に復旧可能	
  
          •    これを使わざるを得ない時点で多少のデータロストは覚悟する
               こと	
  
          •    でもこれがなければバイナリエディタで直接いじるしか手はな
               い	
  
          •    CDH3u4、CDH4.0以降で使用可能	
  
          •    3u3以前のバージョンでも、3u4環境にメタデータを持ってきて
               復旧させ、それを3u3環境に戻すということは一応可能(当然推
               奨しません)	
  
     •    詳細は以下のブログ記事参照(日本語)	
  
          •    hBp://www.cloudera.co.jp/blog/namenode-­‐recovery-­‐tools-­‐for-­‐
               the-­‐hadoop-­‐distributed-­‐file-­‐system.html	
  

34
使い方	
  

     •    hadoop	
  namenode	
  -­‐recover	
   CDH3	
  
     •    hdfs	
  namenode	
  -­‐recover	
     CDH4	
  

     •    editsのロードに失敗した場合、4つのコマンドを使用
          可能	
  
          •    conbnue	
  不正なログをスキップ	
  
          •    stop	
  以降のeditsのロードを停止しfsimageを保存する	
  
          •    quit	
  fsimageを保存せずに終了する	
  
          •    always	
  以降、全ての不正ログをスキップする(conbnueす
               る)	


35
CDH4	
  
     hdfsコマンド	
  

     •    マイナーだがいざというとき便利なコマンドを紹介	
  
     •    hdfs	
  oiv,	
  hdfs	
  oev	
  
           •    oiv	
  は fsimage、oev	
  はedits	
  を人間が読める形式にダンプ
                するコマンド	
  
           •    hdfs	
  oiv	
  -­‐i	
  <fsimageファイル>	
  -­‐o	
  <出力先>	
  -­‐p	
  <出力形式>	
  
           •    -­‐p	
  の出力形式は色々あるので試してみてください	
  
                 •    hdfs	
  oev	
  -­‐p	
  stat	
  はNNアクセス統計が見れる	
  
     •    hdfs	
  getconf	
  
           •    デーモンの一覧、設定値などを取得可能	


36
Too	
  Many	
  Open	
  Files	
  

     •    どういう意味?	
  
          •    Hadoop	
  を実行しているユーザアカウントが、開いている
               ファイルディスクリプタ数の制限にひっかかっている	
     •    何が原因?	
  
          •    nofile	
  のデフォルト値は 1024	
  ファイルで低すぎ	
     •    どうすれば解決できる?	
  
          •    /etc/security/limits.conf	
  を修正する	
                •  hdfs	
  -­‐	
  nofile	
  32768	
  	
  
                •  mapred	
  -­‐	
  nofile	
  32768	
  	
  
                •  hbase	
  -­‐	
  nofile	
  32768	
  	
  
          •    その後サービスを再起動	


37
ノードの名前を変更したのに古い名前で見え続けている	


     •    DNS	
  と	
  /etc/hosts	
  をちゃんと変更したかどうか確認
          してください	
  
     •    サービスは全部再起動してください	


38
トラブルシューティング	
  
MapReduce	
  
Too	
  many	
  fetch-­‐failures	
  

•    どういう意味?	
  
     •    Reducer	
  の	
  fetch	
  操作が	
  mapper	
  出力の取得に失敗して
          いる	
  
     •    Too	
  many	
  fetch	
  failures	
  は特定の	
  TT(	
  =	
  ブラックリスト入り
          の	
  TT)	
  で発生する	
  
•    何が原因?	
  
     •    DNS	
  の問題	
  
     •    mapper	
  側に十分な	
  reducer	
  用	
  hBp	
  スレッドがない	
  
     •    JeByのバグ(CDH3u1以前)	
  
Too	
  many	
  fetch-­‐failures	
  解決策	
  

•    mapタスクの80%	
  が終わってから	
  reduce	
  タスクをス
     タートさせる	
  
     •    大きいジョブがたくさんの	
  reducer	
  を	
  wait	
  状態にし続けな
          いようにする	
                                               CDH3,	
  MR1	
  
     •    mapred.reduce.slowstart.completed.maps	
  =	
  0.80	
   CDH4(MR2)	
  
     •    mapreduce.job.reduce.slowstart.completedmaps	
  =	
  0.80	
  
•    map	
  出力を	
  reducer	
  に供給するために	
  TT	
  に使用さ
     れるスレッド数を大きくする	
  
     •    tasktracker.hBp.threads	
  =	
  80	
               CDH3,	
  MR1	
  

     •    mapreduce.tasktracker.hBp.threads	
  =	
  80	
     CDH4(MR2)	
  
Too	
  many	
  fetch-­‐failures	
  解決策(続き)	
  

•    map	
  出力を取得するために	
  reducer	
  に使用される
     並列コピーの数を指定する	
  
     •    SQRT(ノード数)	
  して一の位を切り下げ(例:	
  500ノード→20,	
  
          1000ノード→30)	
  
     •    mapred.reduce.parallel.copies	
           CDH3,	
  MR1	
  

     •    mapreduce.reduce.shuffle.parallelcopies	
   CDH4(MR2)	
  
•    CDH3u1以前は	
  JeBy	
  のバグで	
  fetch	
  failure	
  を起こし
     やすいので使わない	
  
     •    CDH3u2	
  に上げましょう	
  (MAPREDUCE-­‐2980)	
  
Reduce	
  側でOOME	
  

•    mapred.tasktracker.reduce.tasks.maximum	
  を減らす	
  
•    タスクスロット数	
  *	
  ulimit	
  は	
  RAM	
  の	
  50%	
  に保つ	
  
     •    こうすれば他のサービスのRAM分を確保しつつ、swapが
          発生しない	
  
JobTrackerでOOME	
  

     •    どういう意味?	
  
          •    JT	
  のメモリ使用量の合計 >	
  割り当て RAM	
  
     •    何が原因?	
  
          •    タスクが小さすぎ	
          •    job	
  ヒストリが多すぎ	


44
JobTrackerでOOME	
  解決策	
  
     •    サマリーの出力によって確認可能	
          •    sudo	
  -­‐u	
  mapred	
  jmap	
  -­‐J-­‐d64	
  -­‐histo:live	
  <PID	
  of	
  JT>	
  
     •    JT	
  のヒープ領域を増やす	
     •    JT	
  と NN	
  のノードを分ける	
  
     •    HDFS側でブロックサイズを増やす(128→256MB)	
  
     •    スプリットサイズの最小値を256MBに増やす	
  
          •    mapred.min.split.size	
                       CDH3,	
  MR1	
  
          •    mapreduce.input.fileinpuvormat.split.minsize	
 CDH4(MR2)	
  
     •    mapred.jobtracker.completeuserjobs.maximum	
  を 5	
  に
          減らす 	
          •    JT	
  はメモリをより頻繁にクリンナップするようになり、必要な
               RAM	
  が減る	


45
Not	
  Able	
  to	
  Place	
  Enough	
  Replicas	
  
     •    どういう意味?	
  
          •    NN	
  が一部の DN	
  を選択できない	
  
     •    何が原因?	
  
          •    dfs	
  のレプリケーション数 >	
  利用可能な DN	
  の数	
                •    ディスク領域不足による 利用可能 DN	
  数の不足	
                •    MRジョブファイルのレプリケーションファクタのデフォルト値は 10	
  と高すぎ	
  
                      •    mapred.submit.replicabon	
               CDH3,	
  MR1	
  
                      •    mapreduce.client.submit.file.replicabon	
 CDH4(MR2)	
  
          •    NN	
  がブロック設置ポリシーを満たすことができない	
                •    もしラック数が2より多い場合、ブロックは少なくとも2つのラック上に存在していな
                     ければならない	
  
          •    DN	
  がデコミッション中	
          •    DN	
  に高い負荷がかかっている	
  
          •    ブロックサイズが不必要に大きい	
          •    十分な xciever	
  スレッドがない	
                •    DN	
  が扱えるスレッド数はデフォルト 256	
  でとても低い	
                •    パラメータのスペルミスに注意	


46
Not	
  Able	
  to	
  Place	
  Enough	
  Replicas	
  解決策	
  

     •    DNからの並列ストリームを保持するためのスレッド数を	
  4096	
  
          として、DN	
  を再起動する	
  
           •  dfs.datanode.max.xcievers	
  	
       CDH3,	
  MR1	
  

           •  dfs.datanode.max.transfer.threads	
   CDH4(MR2)	
  
           •  オープンされるファイル数	
  =	
  xceiver	
  *	
  DNの数	

     •    ダウンしてるノードやラックを探す	
     •    ディスク領域を確認する	
          •    log	
  ディレクトリが容量を食っているか、暴走したタスクが
               ディスクの空きを埋めてるかもしれない	
     •    リバランスしましょう	

47
ENOENT:	
  No	
  such	
  file	
  or	
  dir	
  

     •    どういう意味?	
  
          •    ディスク領域がいっぱい、あるいはパーミッションエラー	
  
     •    解決策	
  
          •    dfs.datanode.du.reserved	
  をチェック	
  
                •    10%	
  に設定されている場合、1TB	
  のディスクなら	
  100GB	
  がDN以
                     外のために予約(つまり使用可能な領域は約900GB)	
  
          •    ファイルパーミッションをチェック	
  
                •    例えば userlog	
  ディレクトリは mapred:mapred	
  で	
  755	
  である必要
                     がある	


48
その他のトラブルシューティング	
  

     •    JTが起動できない	
  
          •    core-­‐site.xml	
  のdefault.name	
  プロパティを確認してくださ
               い	


49
CDHのアップグレード	
  
アップグレードのメリット	
  

     •      性能が上がる	
  
     •      機能が増える	
  
            •    詳細は別セッション「CDH4.1オーバービュー」参照	
  
     •      バグ・制限事項がなくなる	
  
            •    メジャーバージョンアップにより過去の問題が一気に解決	
  
     •      アップグレードガイド(英語)	
  
            •    hBps://ccp.cloudera.com/display/CDH4DOC/Upgrading
                 +from+CDH3+to+CDH4	


51
HDFSアップグレードにまつわる誤解	
  

     •    データロストの危険がある?	
  
          •    ありません	
  
          •    でもメタデータのバックアップはきちんととるように!	
  
     •    途中でロールバックできない?	
  
          •    できます	
  
          •    hadoop	
  dfsadmin	
  -­‐finalizeUpgrade	
  を実行するまでは
               hadoop	
  dfsadmin	
  -­‐rollBack	
  でロールバック可能	


52
さらなる高みへ	


53	
  
オライリー「Hadoop」	
  

                •      通称「象本」	
  
                •      Cloudera	
  の	
  Tom	
  White	
  著	
  
                •      日本語版は2版まで刊行	
  
                •      英語版は3版(Hadoop2.0対
                       応、HAの話なども追加)	
  
                •      運用の話も詳しく書かれて
                       います(特に9、10章)	


O’reilly「Hadoop	
  Operabons」	
  

                      •    通称はまだない	
  
                      •    Cloudera	
  の	
  Eric	
  Sammer著	
  
                      •    日本語版未刊行	
  
                      •    今日話をした内容は大体
                           載っています	
  
Cloudera	
  University	
  
 運⽤用・構築に関するトレーニングも⾏行行っています!

                                    英語 :h"p://university.cloudera.com	
  
                                   日本語:h"p://www.jp.cloudera.com/university	


メニュー                  説明
オンラインリソース             ビデオ、トレーニングの仮想マシン
                      などのリソースをダウンロード可能
トレーニング                トレーニングコースの内容、⽇日程、
                      会場などの情報
認定資格                  Hadoop/HBase認定資格の情報


56	
                    ©2012	
  Cloudera,	
  Inc.	
  All	
  Rights	
  Reserved.	
  
57